Slik kan du lage en utvikler- og dataplattform med åpne løsninger 🏗️
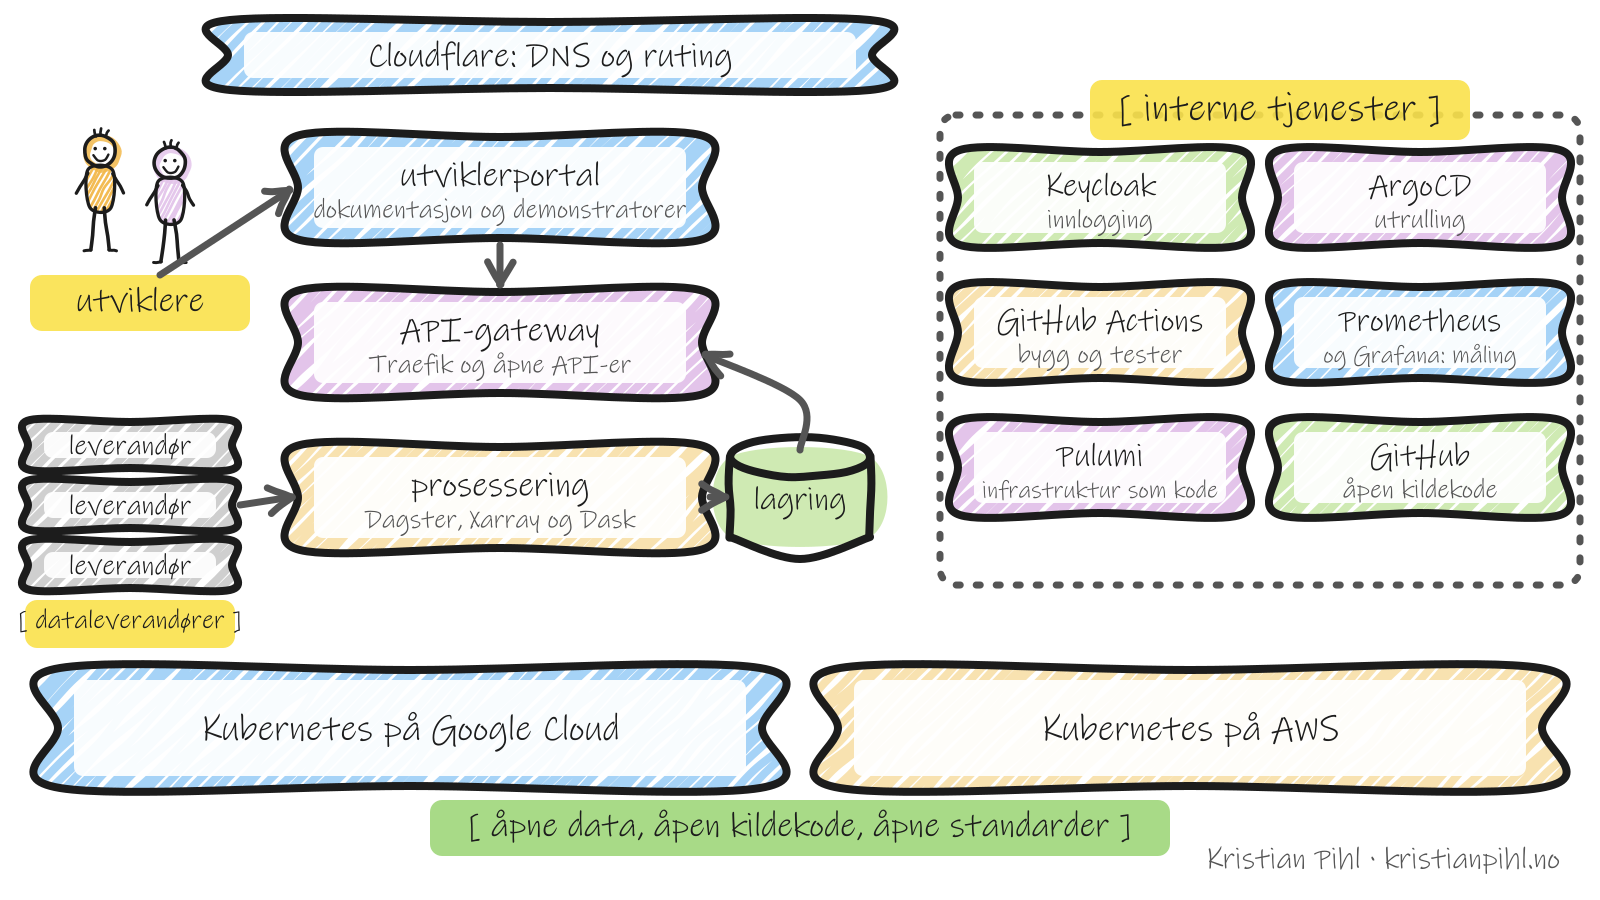
Jeg var produkt- og prosjektleder i en mulighetsstudie for OpenEPI, en åpen plattform for klima- og naturdata. Her er arkitekturen teamet anbefalte, og verktøyene vi brukte i forprosjektet.
Tekst: Kristian Pihl
Tema: Arkitektur
Målet 🎯
OpenEPI skulle gi utviklere enkel tilgang til åpne klima-, natur- og miljødata, slik at de kan bygge løsninger oppå dem.
Plattformen skulle være utviklerfokusert, og den skulle være åpen på alle nivåer:
- Åpne data
- Åpen kildekode
- Åpne standarder og formater
- Åpne API-er
Åpen kildekode betyr også mindre risiko for innlåsing hos én leverandør.
Prinsippene 🧭
- Skalerbar og modulær: Komponenter skal kunne legges til og fjernes
- Flere skyleverandører: Den skal fungere på tvers av skyer for å unngå innlåsing
- Åpne standarder: Og dokumenterte API-er med standardisert metadata
- Infrastruktur som kode og containere
- Dataportabilitet: Dataene skal kunne flyttes
Arkitekturen: åtte byggeklosser 🧩
- Utviklerportal: Inngangen for utviklerne, med dokumentasjon og datakatalog
- Demonstratorer: Eksempler på hva API-ene kan brukes til
- API-er og datatilgang: Der utviklerne henter dataene
- Prosessering og transformasjon: Data fra leverandørene gjøres klare for API-ene
- Integrasjon og lagring
- Eksterne dataleverandører
- Måling og overvåking: Følge med på bruk og helse
- Interne tjenester: Utrulling, innlogging, bygging og orkestrering
Verktøyene i forprosjektet 🛠️
- Cloudflare: DNS og ruting (og utviklerportalen)
- GitHub: Åpen kildekode, bygg med GitHub Actions og containerbilder
- Pulumi: Infrastruktur som kode, skrevet i Python
- Kubernetes: Samme drift på Google Cloud og AWS, med ArgoCD for utrulling
- Traefik: API-gateway
- Keycloak: Innlogging
- Prometheus og Grafana: Måling av bruk
- Dagster: Orkestrering av datapipelines
- Python og TypeScript: FastAPI og Pydantic, Next.js og React
Hva vi lærte 📚
- Kubernetes krever mye av plattformteamet, særlig når det skal skalere
- Én stor Pulumi-stack ble treg. Mindre stacker løste det
- Spark passet dårlig til store raster- og flerdimensjonale data. Xarray og Dask passet bedre
- Forprosjektet tok snarveier, for eksempel på hemmeligheter. Fullskala krever bedre løsninger
- Arkitekturen skal utvikle seg. Valgene var startpunkter, ikke fasit
Oppsummert 🧭
- Åpenhet på alle nivåer: data, kode, standarder og API-er
- Tenk utviklerne først
- Hold deg uavhengig av én skyleverandør
- Start enkelt, og la arkitekturen utvikle seg
En åpen plattform bygger du ved å velge åpne løsninger hele veien.